Tag: Prompt Benchmark GEO
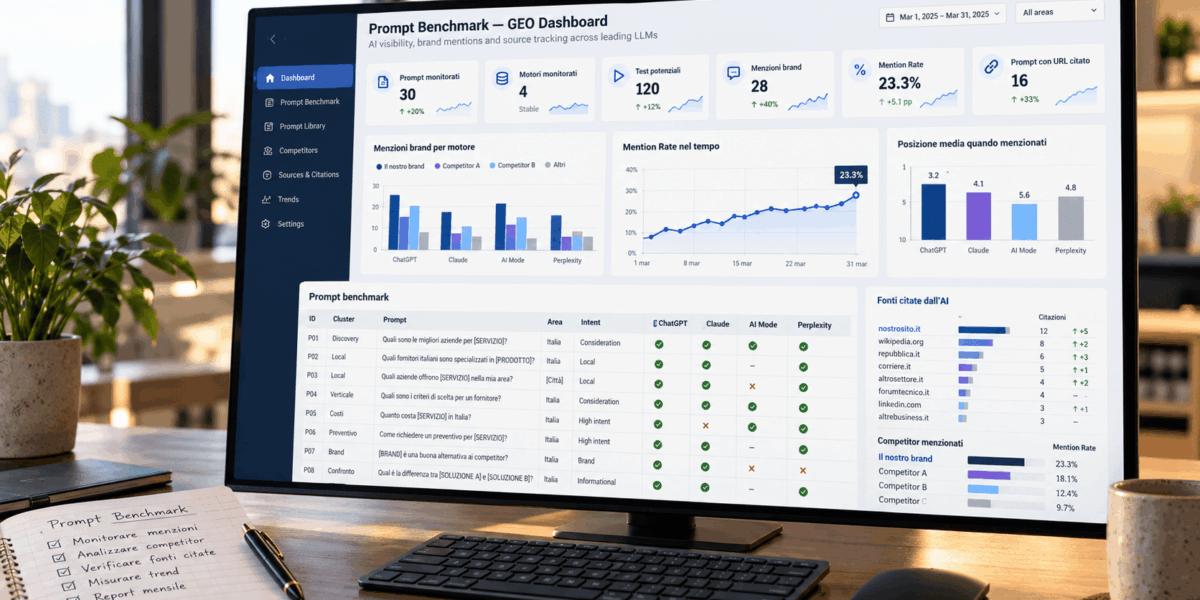
Prompt Benchmark GEO: cos’è e come funziona – Scarica il template
Misurare la visibilità di un brand su ChatGPT, Gemini, AI Mode, Claude o Perplexity è molto diverso dal controllare il ranking di una keyword su Google.
Nella SEO tradizionale possiamo partire da una query, verificare la posizione di una pagina e osservare impression, click e CTR.
Con i motori AI il problema cambia.
La risposta può variare in funzione del prompt, del contesto, del motore utilizzato e delle fonti recuperate. Inoltre il brand può essere menzionato senza essere citato, può comparire tra le fonti senza essere raccomandato oppure può essere consigliato soltanto per alcune tipologie di domanda.
Per questo serve costruire un sistema di osservazione stabile.
Il Prompt Benchmark GEO è esattamente questo: un insieme controllato di domande rappresentative del percorso decisionale degli utenti, eseguite periodicamente sugli stessi motori AI e registrate in modo strutturato.
L’obiettivo non è chiedere una volta a ChatGPT:
“Conosci la mia azienda?”
ma verificare sistematicamente:
in quali domande il brand compare, rispetto a quali concorrenti, con quale frequenza e attraverso quali fonti.
Il punto di partenza non sono le keyword, ma i bisogni degli utenti
La qualità del benchmark dipende soprattutto dai prompt.
Un errore comune consiste nel trasformare semplicemente una keyword SEO in una domanda.
Se la keyword è:
“taglio laser tubi Milano”
il benchmark non dovrebbe contenere soltanto:
Quali aziende fanno taglio laser tubi a Milano?
Gli utenti possono formulare la stessa esigenza in modi molto differenti:
Quali aziende italiane sono specializzate nel taglio laser 3D di tubi?
Cerco un fornitore per il taglio laser di tubi in acciaio inox: chi posso valutare?
Quali caratteristiche deve avere una buona azienda specializzata nel taglio laser tubi?
Quali sono le alternative ad Azienda X per questa lavorazione?
Azienda Y è un buon fornitore per questo tipo di progetto?
È qui che il Prompt Benchmark diventa differente da un semplice keyword tracker.
Le domande devono rappresentare il modo in cui un potenziale cliente prende una decisione.
Da dove arrivano i prompt
Il benchmark dovrebbe essere costruito combinando diverse fonti.
Le più interessanti sono spesso già disponibili all’interno dell’azienda:
- domande ricevute dai commerciali;
- email dei clienti;
- richieste di preventivo;
- FAQ;
- ticket di assistenza;
- query di Search Console;
- ricerca interna del sito;
- conversazioni con prospect;
- recensioni;
- domande sui social;
- query utilizzate dai competitor.
A queste possiamo aggiungere un lavoro di ricerca.
L’obiettivo è costruire un campione di prompt che rappresenti differenti momenti del customer journey.
Nel template neutro ho mantenuto 30 prompt, una dimensione sufficientemente ampia per ottenere un primo quadro senza rendere il benchmark ingestibile.
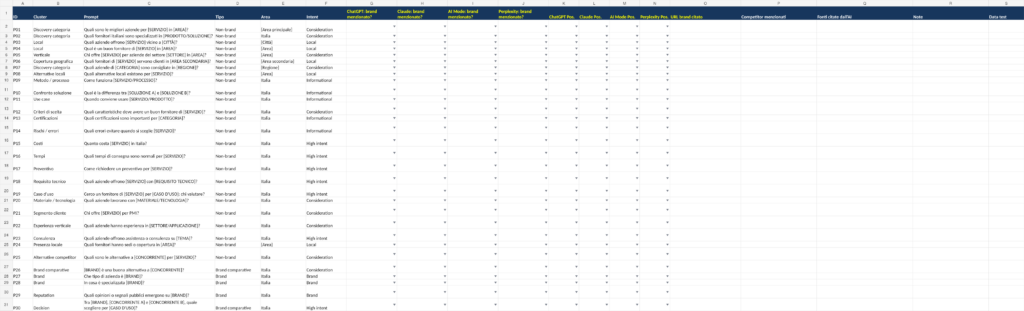 Come sono organizzati i prompt
Ogni prompt viene classificato attraverso alcune dimensioni.
Nel file troviamo innanzitutto un cluster, che indica il tema della domanda.
Per esempio:
Discovery categoria
Quali sono le migliori aziende per [SERVIZIO] in [AREA]?
Local
Quali aziende offrono [SERVIZIO] vicino a [CITTÀ]?
Metodo o processo
Come funziona [SERVIZIO/PROCESSO]?
Costi
Quanto costa [SERVIZIO] in Italia?
Caso d’uso
Cerco un fornitore di [SERVIZIO] per [CASO D’USO]: chi valutare?
Brand comparative
[BRAND] è una buona alternativa a [CONCORRENTE]?
Decision
Tra [BRAND], [CONCORRENTE A] e [CONCORRENTE B], quale scegliere per [CASO D’USO]?
Questa struttura serve a evitare che il benchmark misuri soltanto le query nelle quali il brand è già conosciuto.
La parte più interessante è spesso costituita dai prompt non-brand.
Sono quelli nei quali l’utente non conosce ancora l’azienda e chiede al motore AI di suggerire una soluzione.
Brand prompt e non-brand prompt misurano cose differenti
Una domanda come:
In cosa è specializzata [BRAND]?
serve soprattutto a verificare se il motore ha una rappresentazione corretta dell’azienda.
Una domanda come:
Quali aziende sono specializzate in [SERVIZIO]?
misura invece qualcosa di molto più competitivo:
il brand entra spontaneamente nel consideration set costruito dall’AI?
Nel benchmark conviene quindi mantenere entrambe le categorie.
Possiamo distinguere almeno:
- Non-brand
- Brand
- Brand comparative
e attribuire anche un intent:
- Informational
- Local
- Consideration
- High intent
- Brand
In questo modo possiamo scoprire, per esempio, che un’azienda è molto conosciuta quando viene cercata direttamente ma quasi invisibile quando il potenziale cliente non conosce ancora il suo nome.
Questa è una delle informazioni più interessanti che un Prompt Benchmark può far emergere.
Come si esegue il Prompt Benchmark
Nel template ho previsto quattro motori:
ChatGPT, Claude, Google AI Mode e Perplexity.
Con 30 prompt abbiamo quindi:
30 prompt × 4 motori = 120 test potenziali.
Il numero dei motori può naturalmente cambiare.
L’importante è mantenere stabile il set scelto quando si confrontano periodi differenti.
Per ogni combinazione prompt × motore vengono registrati diversi segnali.
1. Il brand viene menzionato?
È il primo livello.
La colonna:
“brand menzionato?”
deve indicare se il nome dell’azienda compare nella risposta.
Nel template utilizziamo:
- Sì
- No
- Parziale
Questa informazione alimenta il Mention Rate.
Se il brand compare in 30 dei 120 test effettuati:
Mention Rate = 25%.
Non significa che il brand detenga il 25% di Share of Voice del mercato.
Significa che è presente nel 25% delle risposte analizzate.
Questa distinzione è importante.
2. In quale posizione compare?
Quando il motore produce una lista ordinata o comunque una sequenza chiaramente interpretabile, registriamo anche la posizione.
Per esempio:
- Competitor A
- Brand
- Competitor B
Il brand avrà posizione 2.
Non tutte le risposte AI producono però una classifica.
La posizione va quindi registrata soltanto quando è realmente osservabile, evitando di forzare una gerarchia che il modello non ha espresso.
3. Il sito del brand viene citato?
Questo è un segnale diverso dalla menzione.
Se l’AI scrive il nome dell’azienda abbiamo una brand mention.
Se tra i riferimenti compare una pagina del suo dominio abbiamo anche una citation presence.
Nel file esiste quindi una colonna separata:
URL brand citato
Qui viene inserita la pagina effettivamente mostrata dal motore.
Può essere:
- homepage;
- pagina servizio;
- articolo;
- FAQ;
- case study;
- pagina prodotto.
Questo permette di capire quali asset del sito stanno diventando fonti per l’AI.
4. Quali competitor vengono menzionati?
Il Prompt Benchmark non serve soltanto a osservare il proprio brand.
Dobbiamo registrare anche le altre aziende che compaiono.
La colonna:
Competitor menzionati
permette nel tempo di calcolare un vero Competitor Share of Voice.
Se su 30 prompt di categoria:
- Brand A compare 18 volte;
- Brand B 14;
- Brand C 9;
- il nostro brand 5;
abbiamo una fotografia estremamente interessante della categoria percepita dal motore AI.
Non stiamo più analizzando soltanto una SERP.
Stiamo analizzando il consideration set generato dall’intelligenza artificiale.
5. Quali fonti cita l’AI?
Un’altra colonna fondamentale è:
Fonti citate dall’AI.
Qui registriamo i domini utilizzati nelle risposte.
Non soltanto il nostro.
Possiamo quindi scoprire che i competitor vengono sostenuti soprattutto da:
- testate specializzate;
- associazioni;
- directory;
- Wikipedia;
- recensioni;
- marketplace;
- partner;
- siti istituzionali;
- case study;
- contenuti proprietari.
Questa informazione può cambiare completamente la strategia GEO.
La domanda non sarà più soltanto:
“Quale contenuto devo scrivere?”
ma:
“In quali fonti devo essere presente perché i motori AI possano trovarmi e verificarmi?”
Il Dashboard: trasformare 120 test in pochi KPI leggibili
Il primo foglio del file sintetizza le rilevazioni.
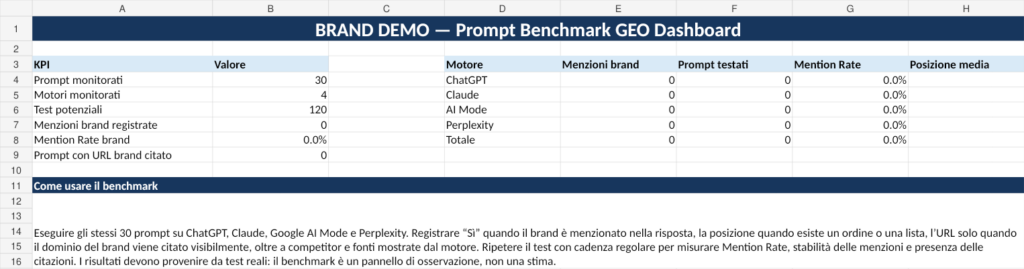
Il Dashboard mostra innanzitutto:
Prompt monitorati
Quante domande fanno parte del benchmark.
Motori monitorati
Quanti sistemi AI vengono verificati.
Test potenziali
Prompt × motori.
Nel nostro template:
30 × 4 = 120.
Troviamo poi:
Menzioni brand registrate
numero totale di risposte nelle quali il brand è stato menzionato.
Mention Rate
rapporto tra menzioni e test effettivamente eseguiti.
Prompt con URL brand citato
numero di prompt nei quali almeno una pagina del dominio è comparsa tra le citazioni registrate.
La seconda parte del Dashboard permette inoltre di confrontare i singoli motori.
Possiamo scoprire, per esempio, che il brand ha:
- Mention Rate 35% su ChatGPT;
- 18% su Claude;
- 42% su AI Mode;
- 27% su Perplexity.
Questa informazione può essere molto più utile di un generico:
“Il brand è visibile sull’AI.”
Dal benchmark al Piano GEO
Il benchmark non deve restare un foglio di monitoraggio.
Deve produrre decisioni.
Per questo il template contiene anche un foglio Piano GEO.
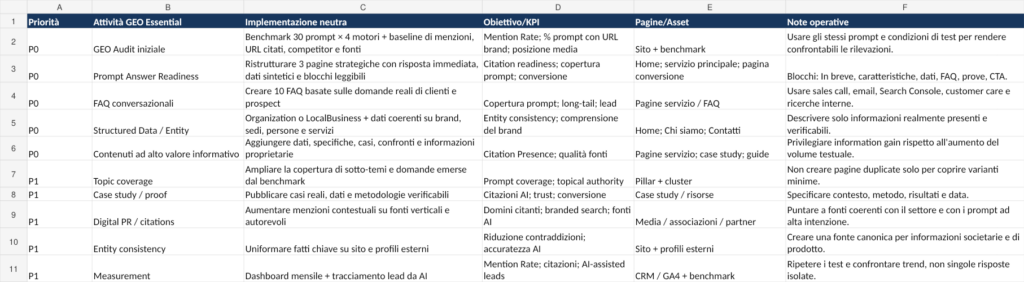
Qui le evidenze emerse dal benchmark vengono trasformate in attività operative.
Per esempio, se il brand non compare nei prompt relativi ai costi, può emergere la necessità di creare contenuti più chiari su:
prezzi, variabili di costo, preventivi e modalità di acquisto.
Se non compare nei prompt locali, possiamo intervenire su:
Local SEO, pagine territoriali, entity consistency e dati sulle sedi.
Se viene menzionato ma il proprio sito non viene mai citato, il problema potrebbe riguardare:
citation readiness e qualità informativa delle pagine.
Se i competitor vengono citati attraverso media verticali e directory, può emergere una necessità di:
Digital PR e presenza su fonti esterne autorevoli.
Il benchmark diventa quindi un collegamento tra:
misurazione → gap → attività GEO.
Il foglio Fonti e Citazioni
L’ultimo livello consiste nel costruire una mappa delle fonti.
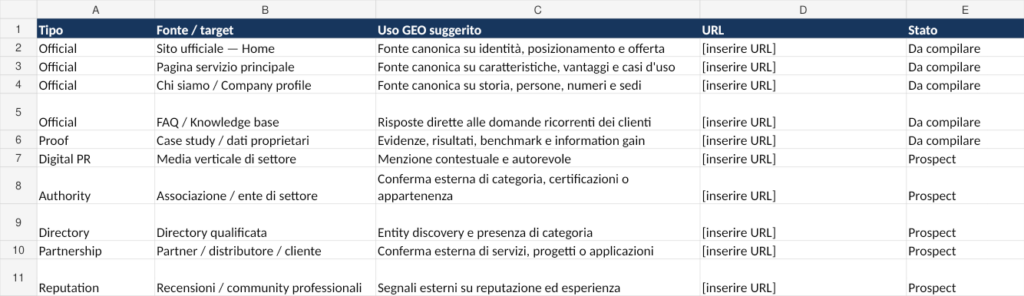
Nel template neutro che puoi scaricare qui ho distinto diverse tipologie.
Fonti proprietarie
Per esempio:
- Home;
- pagina servizio;
- Chi siamo;
- FAQ;
- case study.
Sono gli asset sui quali abbiamo controllo diretto.
Fonti esterne
Possono comprendere:
- media verticali;
- associazioni di settore;
- directory qualificate;
- partner;
- clienti;
- community professionali;
- recensioni.
Per ciascuna possiamo registrare:
tipo → fonte → possibile utilizzo GEO → URL → stato.
In questo modo l’analisi delle citazioni dei concorrenti diventa una vera attività di prospecting editoriale e Digital PR.
Se una determinata testata compare frequentemente come fonte nelle risposte AI della nostra categoria, quella testata diventa automaticamente più interessante per la strategia GEO.
Quanto spesso bisogna ripetere il Prompt Benchmark?
Non ha molto senso eseguire 30 prompt oggi e considerare il risultato definitivo.
Le risposte AI cambiano.
Cambiano i modelli, le fonti disponibili, il retrieval, i contenuti del web e la concorrenza.
Il valore del benchmark nasce dalla ripetizione dello stesso esperimento.
Una buona cadenza operativa può essere mensile.
Ogni mese utilizziamo:
- gli stessi prompt;
- gli stessi motori;
- gli stessi criteri di registrazione.
Possiamo così osservare il trend.
Per esempio:
| Mese | Mention Rate |
|---|---|
| Gennaio | 14% |
| Febbraio | 17% |
| Marzo | 22% |
| Aprile | 29% |
Il singolo risultato conta relativamente.
La direzione del trend conta molto di più.
Un Prompt Benchmark non è una classifica scientifica dei modelli
È importante anche chiarire il limite dello strumento.
Un LLM non restituisce necessariamente la stessa risposta a ogni esecuzione.
Il benchmark non deve quindi essere interpretato come una misurazione deterministica simile al ranking di una keyword.
È un sistema di osservazione controllato.
Serve per individuare:
- pattern;
- gap;
- competitor ricorrenti;
- fonti ricorrenti;
- categorie nelle quali il brand è forte;
- categorie nelle quali è assente;
- evoluzione nel tempo.
Per questo nel file neutro ho aggiunto una regola esplicita:
I risultati devono provenire da test reali: il benchmark è un pannello di osservazione, non una stima.
Dal Prompt Benchmark alla strategia GEO
Un buon benchmark dovrebbe alla fine permetterci di rispondere a cinque domande.
1. L’AI conosce il mio brand?
Lo osserviamo attraverso i prompt branded.
2. L’AI mi considera quando l’utente non mi conosce ancora?
Lo misuriamo con i prompt non-brand.
3. In quali topic vengo associato alla categoria?
Lo scopriamo confrontando cluster e intent.
4. Quali competitor vengono consigliati al mio posto?
Li registriamo sistematicamente.
5. Quali fonti stanno sostenendo quelle raccomandazioni?
Le analizziamo attraverso le citazioni.
A quel punto la GEO smette di essere una disciplina astratta.
Possiamo passare da:
“Voglio essere più visibile su ChatGPT.”
a indicazioni molto più precise:
“Il brand compare nel 12% dei prompt non-brand relativi al servizio principale, mentre due concorrenti superano il 40%. Il nostro dominio non viene quasi mai citato e le fonti più utilizzate dall’AI sono tre portali verticali nei quali non siamo presenti.”
Questa è un’informazione sulla quale si può costruire una strategia.
Scarica il template neutro del Prompt Benchmark GEO
Ho preparato una versione completamente anonimizzata e riutilizzabile del file.
Contiene:
- 30 prompt template;
- 4 motori AI;
- monitoraggio delle menzioni;
- posizione del brand;
- URL citati;
- competitor;
- fonti;
- Dashboard automatico;
- Piano GEO;
- mappa Fonti e Citazioni.
Scarica la nuova guida DISCOVER DESKTOP DOMINATION

SEO NEWS


PARLIAMONE IN CALL
Migliora la tua SEO grazie a una consulenza personalizzata
PAGINE PRINCIPALI
NEWS DA SEO AND MARKETING
- Prompt Benchmark GEO: cos’è e come funziona – Scarica il template
- Menzioni, citazioni e fonti nella GEO: tre segnali diversi da non confondere
- Fare GEO per LLM: gli aspetti tecnici per essere citati dai motori di ricerca AI
- SEO per convertire: come trasformare il traffico organico in clienti reali
- Consulenza GEO – Generative Engine Optimization